Para termos melhores modelos de IA, precisamos de mais e melhores dados em Português
Publicado em
Publicado originalmente no Twitter em 10 de setembro de 2026
Temas: Inteligência artificial, Processamento de linguagem natural
🧶 Um dos motivos de os modelos de #IA não serem incríveis em Português (além do fato das big techs não serem brasileiras) é a falta de dados de qualidade.
O modelo de transcrição Whisper, por ex, só funciona bem em nossa língua na versão large, que consome bem mais hardware.
Uma iniciativa que ajuda a reduzir esse problema é o Common Voice, da Mozilla. Você se cadastra e pode colaborar pelo próprio navegador, seja gravando trechos de áudio, validando trechos gravados por outras pessoas ou sugerindo frases para serem gravadas.
De tempos em tempos a Mozilla organiza o que foi coletado e publica o dataset sob uma licença aberta, permitindo que qualquer um treine modelos com esses dados. Com modelos abertos melhores, a vida de mais falantes de Português fica mais fácil.
Nenhum dado de identificação de quem está contribuindo é publicado, apenas algumas informações relevantes para diversidade (gênero, idade e sotaque - mas não é obrigatório fornecer). Infelizmente, ainda tem pouca representação feminina para Português.
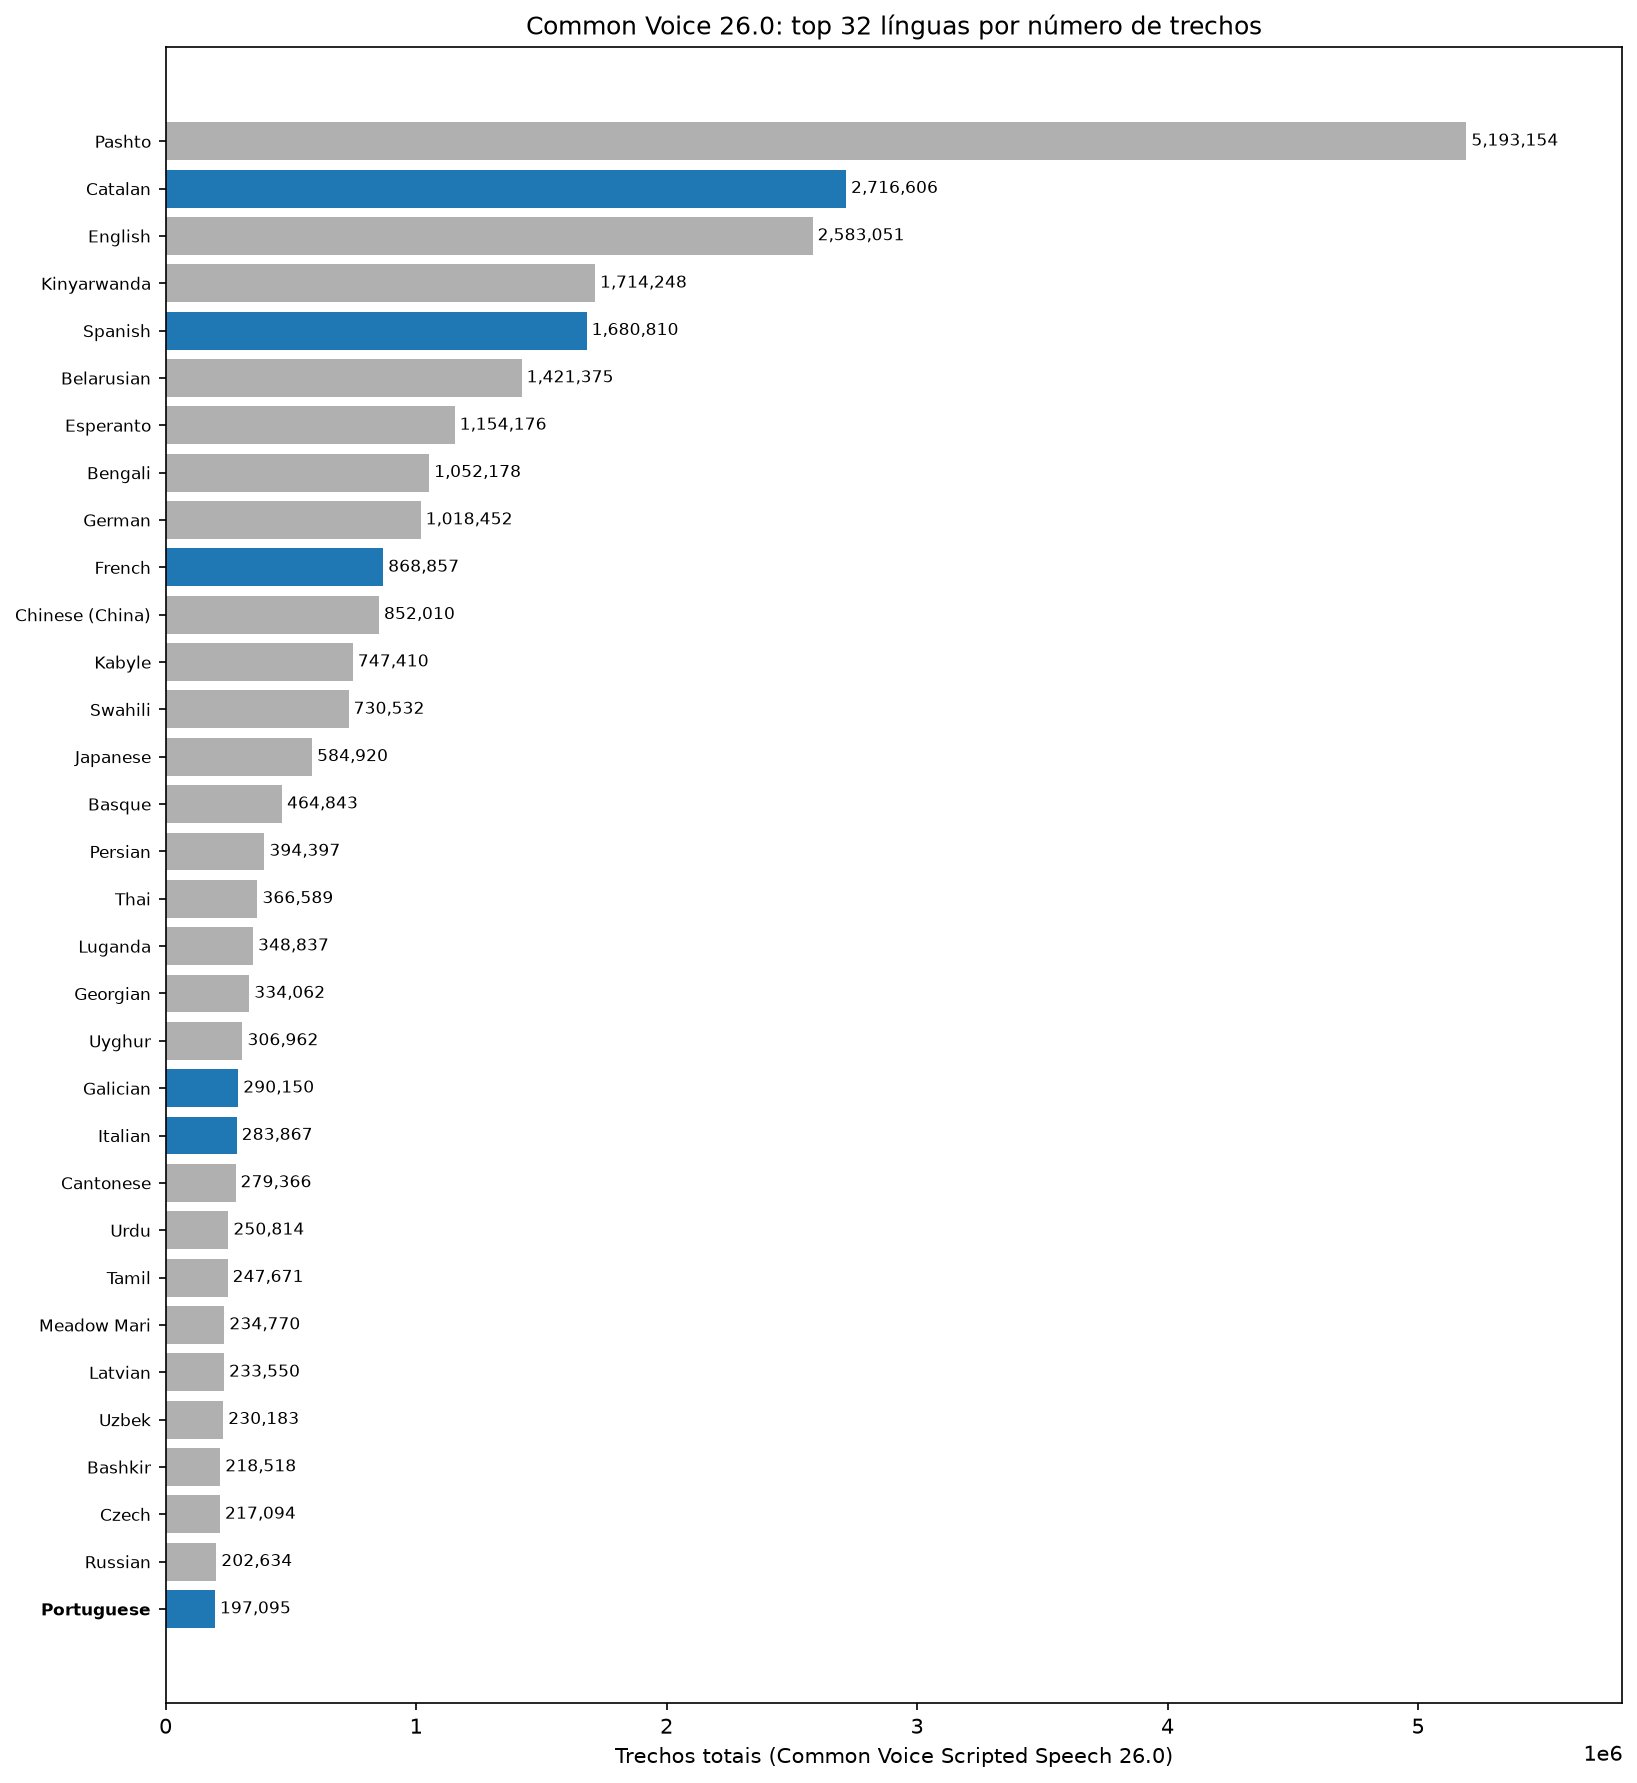
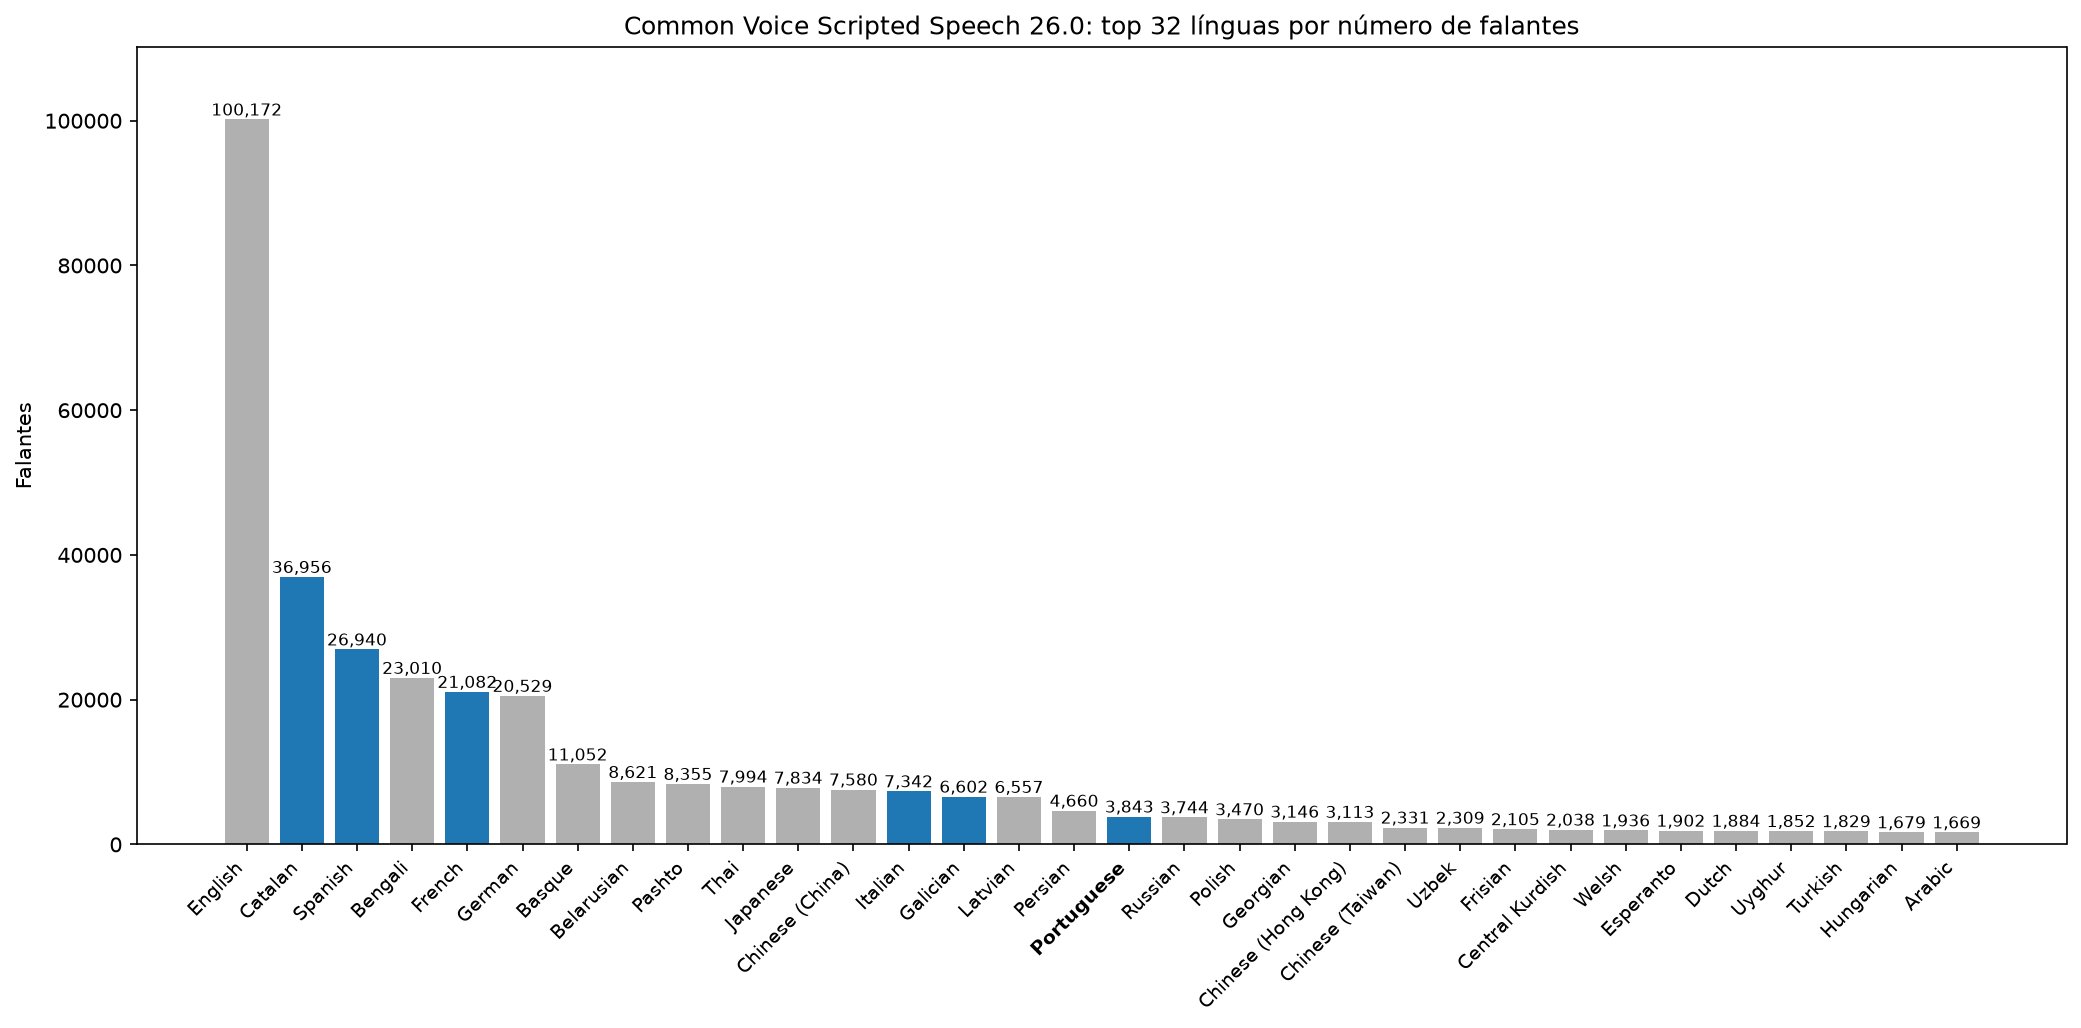
No Common Voice 26.0, Inglês tem 2,6 milhões de trechos gravados por 100 mil falantes, enquanto o Português tem 197 mil trechos de apenas 3,8 mil falantes. Espanhol: 1,7 milhão de trechos, 27 mil falantes. Pouca diversidade para um modelo aprender bem. =/
Também dá pra contribuir com outras línguas, tipo Inglês - quanto mais brasileiros falando em Inglês, melhor os modelos aprenderão "Inglês com sotaque brasileiro", que também inclui mais casos de uso em que os modelos ficarão melhores adaptados a nós.
Em breve a Mozilla fechará uma versão nova do "pacote" e publicará uma nova versão. Colabore: https://commonvoice.mozilla.org/